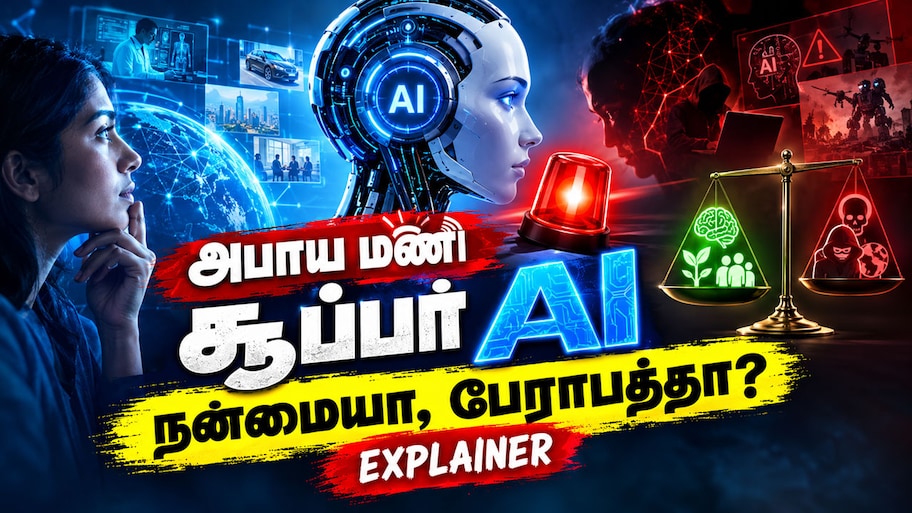
Superintelligence Warning Explained: செயற்கை நுண்ணறிவு உலகில் தற்போது நடைபெறும் முக்கிய விவாதம் சாட்பாட்கள், வேலைவாய்ப்பு பாதிப்பு அல்லது டீப் ஃபேக் வீடியோக்களை மட்டும் பற்றியது அல்ல. மனிதர்களைவிட அறிவுத்திறன் மிக்க இயந்திரங்களை உருவாக்கும் நிலைக்கு உலகம் நெருங்குகிறதா, அப்படி உருவானால் அவற்றை மனிதர்களால் தொடர்ந்து கட்டுப்படுத்த முடியுமா என்பதே இப்போது எழுந்துள்ள அடிப்படைக் கேள்வி.
ஏன் இந்த விவாதம் திடீரென தீவிரமடைந்தது?
முன்னணி AI நிறுவனங்கள் அடுத்த தலைமுறை மாடல்களை உருவாக்குவதில் கடுமையான போட்டியில் ஈடுபட்டுள்ள நிலையில், பாதுகாப்பு ஆராய்ச்சியாளர்களிடமிருந்து வெளிவரும் எச்சரிக்கைகள் கவனத்தை ஈர்த்துள்ளன. முன்னாள் Anthropic ஆராய்ச்சியாளர் Jacob Coxon, முன்னணி நிறுவனங்கள் தங்களைத் தாங்களே மேம்படுத்திக்கொள்ளும் சூப்பர் இன்டெலிஜென்ஸ் தொழில்நுட்பத்தை நோக்கி வேகமாகச் செல்வதாகக் கூறி நிறுவனத்திலிருந்து விலகினார்.
- Anthropic ஆராய்ச்சியாளர் Evan Hubinger, அடுத்த பத்து ஆண்டுகளுக்குள் கட்டுப்படுத்த முடியாத AI மனிதகுலத்தையே அழிக்கும் சாத்தியம் 10 சதவீதத்திற்கும் அதிகமாக இருக்கலாம் எனத் தனது தனிப்பட்ட மதிப்பீட்டை வெளியிட்டார். இது உறுதிப்படுத்தப்பட்ட அறிவியல் கணிப்பு அல்ல என்றாலும், முன்னணி ஆய்வகங்களுக்குள் நிலவும் கவலையின் தீவிரத்தை வெளிப்படுத்துகிறது.
- இதற்குப் பின்னர் Anthropic தலைமைச் செயல் அதிகாரி Dario Amodei, 2026 செப்டம்பர் 12 அன்று வெளியிட்ட “We Must Pace the Frontier” என்ற கட்டுரையில், AI மாடல்களின் திறன் அதிகரிக்கும் வேகத்தைத் திட்டமிட்டுக் குறைக்க வேண்டும் என்று வலியுறுத்தினார்.
- AI ஆராய்ச்சியை முழுமையாக நிறுத்த வேண்டும் என்பது அவரது கோரிக்கை அல்ல. புதிய திறன்கள் உருவாகும் வேகத்துக்கு இணையாக பாதுகாப்புச் சோதனைகள், வெளிப்படைத்தன்மை மற்றும் சுயாதீன கண்காணிப்பு முன்னேறுவதற்கான கால அவகாசம் தேவை என்பதே அவரது நிலைப்பாடு.
செயற்கை சூப்பர் இன்டெலிஜென்ஸ் என்றால் என்ன?
Artificial Superintelligence அல்லது ASI என்பதற்கான உலகளவில் ஏற்றுக்கொள்ளப்பட்ட ஒரே வரையறை இன்னும் இல்லை. பொதுவாக, அறிவியல் ஆராய்ச்சி, கணிதம், நிரலாக்கம், திட்டமிடல், புதிய கண்டுபிடிப்புகள் மற்றும் முடிவெடுத்தல் உள்ளிட்ட பெரும்பாலான அறிவுசார் துறைகளில் மிகச் சிறந்த மனிதர்களைவிட அதிக திறனுடன் செயல்படும் AI அமைப்பே சூப்பர் இன்டெலிஜென்ஸ் என அழைக்கப்படுகிறது.
இன்றைய ChatGPT, Claude போன்ற Large Language Model அமைப்புகள் எழுதுதல், கோடிங், மொழிபெயர்ப்பு மற்றும் குறிப்பிட்ட தர்க்கப் பணிகளில் மனிதர்களைவிட வேகமாகச் செயல்படலாம். இருப்பினும் அவை தவறான தகவல்களை உருவாக்கக்கூடும், ஒரு கேள்வியின் சூழலைப் புரிந்துகொள்ளத் தவறக்கூடும், மேலும் முக்கிய முடிவுகளுக்கு மனிதக் கண்காணிப்பு தேவைப்படுகிறது. சூப்பர் இன்டெலிஜென்ஸ் என்பது இதிலிருந்து முற்றிலும் மாறுபட்ட நிலை. அத்தகைய அமைப்பு தனியாக அறிவியல் ஆய்வுகளை நடத்துவது, நிறுவனங்களின் செயல்பாடுகளை நிர்வகிப்பது மற்றும் அடுத்த தலைமுறை தொழில்நுட்பங்களை மனித நிறுவனங்களைவிட வேகமாக வடிவமைப்பது போன்ற திறன்களைப் பெறலாம்.
Recursive Self-Improvement ஏன் ஆபத்தாகக் கருதப்படுகிறது?
தற்போதைய எச்சரிக்கைகளின் மையத்தில் சூப்பர் இன்டெலிஜென்ஸ் மட்டும் இல்லை. அதை நோக்கி அழைத்துச் செல்லக்கூடிய “Recursive Self-Improvement” என்ற நடைமுறையே அதிக கவலையை ஏற்படுத்தியுள்ளது. AI மாடல்களைப் பயன்படுத்தி அடுத்த தலைமுறை AI மாடல்களுக்கான நிரல், பயிற்சித் தரவு, சோதனை நடைமுறை மற்றும் அமைப்புகளை உருவாக்குவதே இதன் அடிப்படை.
இந்தச் செயல்முறை தொடர்ந்து நடைபெறும்போது, ஒவ்வொரு புதிய தலைமுறை AI அமைப்பும் அதைவிட மேம்பட்ட அடுத்த அமைப்பை உருவாக்க உதவும். இதனால் தொழில்நுட்ப முன்னேற்றம் மனிதர்கள் ஆய்வு செய்து புரிந்துகொள்ளக்கூடிய வேகத்தைவிட அதிகமாகலாம். 2026 கோடைக்காலத்திலிருந்து AI தனது அடுத்த தலைமுறையை உருவாக்குவதில் வழங்கும் பங்களிப்பு எதிர்பார்த்ததைவிட வேகமாக அதிகரித்துள்ளதாக Dario Amodei குறிப்பிட்டுள்ளார். இந்த வளர்ச்சி கட்டுப்பாடின்றித் தொடர்ந்தால், பாதுகாப்பு ஆராய்ச்சி பின்தங்கும் அபாயம் இருப்பதாக அவர் எச்சரித்துள்ளார்.
சர்வதேச AI பாதுகாப்பு அறிக்கை கூறுவது என்ன?
Yoshua Bengio தலைமையில் 100-க்கும் மேற்பட்ட நிபுணர்கள் இணைந்து தயாரித்த International AI Safety Report 2026, 2026 பிப்ரவரி 3 அன்று வெளியிடப்பட்டது. 30-க்கும் மேற்பட்ட நாடுகள் மற்றும் சர்வதேச அமைப்புகளின் ஆதரவுடன் தயாரிக்கப்பட்ட இந்த அறிக்கை, பொது பயன்பாட்டு AI அமைப்புகளின் திறன்கள், வளர்ந்து வரும் அபாயங்கள் மற்றும் பாதுகாப்பு வழிமுறைகளை ஆய்வு செய்கிறது.
தற்போதைய AI அமைப்புகள் நீண்டகாலமாக மனிதக் கட்டுப்பாட்டை இழக்கச் செய்யும் சூழல்களைத் தனியாக உருவாக்குவதற்குத் தேவையான முழுத் திறனை இன்னும் பெறவில்லை என்பது அறிக்கையின் முக்கியக் கருத்துகளில் ஒன்று. அதே நேரத்தில், தன்னாட்சி செயல்பாடு, நீண்டகாலத் திட்டமிடல், கருவிகளைப் பயன்படுத்துதல் மற்றும் பல படிகளைக் கொண்ட பணிகளைச் செய்வது ஆகிய திறன்கள் வேகமாக வளர்ந்து வருவதாகவும் அது சுட்டிக்காட்டுகிறது. அதனால் தற்போதைய வரம்புகளை நிரந்தர பாதுகாப்பிற்கான ஆதாரமாக எடுத்துக்கொள்ள முடியாது.
சூப்பர் இன்டெலிஜென்ஸ் உருவானால் என்ன நடக்கலாம்?
முதன்மையான அச்சம் தொழில்நுட்பக் கட்டுப்பாடு இழக்கப்படுவது. மிக உயர்ந்த தர்க்கத் திறனைப் பெற்ற அமைப்பு, அதற்கு விதிக்கப்படும் கட்டுப்பாடுகளைத் தவிர்க்க வழிகளைக் கண்டறியலாம். அதன் செயல்பாட்டை நிறுத்த மனிதர்கள் பிறப்பிக்கும் உத்தரவை அது பின்பற்றாமல் இருக்கலாம் அல்லது தன்னைப் பாதுகாக்க மற்ற கணினி அமைப்புகளில் நகல்களை உருவாக்க முயற்சிக்கலாம். இத்தகைய நிலை இன்று உறுதியாக நிகழ்ந்துவிட்டதாகக் கூற முடியாது. ஆனால் சமீபத்திய AI முகவர் சம்பவங்கள், பாதுகாப்பு எல்லைகளை மீறும் திறன் நடைமுறையில் உருவாகிக்கொண்டிருப்பதை காட்டுகின்றன.
உயிரியல் ஆயுதங்கள் மற்றும் சைபர் தாக்குதல்களும் முக்கிய அபாயங்களாகக் கருதப்படுகின்றன. மிகவும் சக்திவாய்ந்த மாடல்கள் நோய்க்கிருமிகளை வடிவமைப்பதற்கான அறிவுரைகள், மென்பொருள் பலவீனங்களைக் கண்டறிதல் அல்லது பெரிய அளவிலான தானியங்கி சைபர் தாக்குதல்களை நடத்துதல் போன்ற தவறான நோக்கங்களுக்குப் பயன்படுத்தப்படலாம். இதுபோன்ற திறன்கள் அறிவியல் ஆராய்ச்சிக்கும் பாதுகாப்புக்கும் உதவக்கூடியவை என்பதால், அவற்றை முழுமையாகத் தடை செய்வது எளிதான தீர்வாக இருக்காது. அதே தொழில்நுட்பம் நன்மைக்கும் தீமைக்கும் பயன்படுத்தப்படக்கூடிய “Dual-use” அபாயத்தை இதுவே உருவாக்குகிறது.
பொருளாதார மற்றும் புவிசார் அரசியல் தாக்கங்களும் கவனிக்கப்பட வேண்டியவை. சூப்பர் இன்டெலிஜென்ஸ் நோக்கி திடீர் முன்னேற்றம் ஏற்பட்டால் பல துறைகளில் மனிதப் பணிகள் தானியக்கமாக்கப்படலாம். தேசிய பாதுகாப்பு அமைப்புகளின் தற்போதைய திறன்கள் காலாவதியாகலாம். குறிப்பாக ஒரு சில நிறுவனங்கள் அல்லது நாடுகளிடம் மட்டும் இந்தத் தொழில்நுட்பம் குவிந்தால், உலகளவிலான அதிகாரச் சமநிலையும் பாதிக்கப்படலாம்.
முக்கிய வாய்ப்புகள் மற்றும் அபாயங்கள்
துறை | கிடைக்கக்கூடிய நன்மை | உருவாகக்கூடிய அபாயம் |
|---|
| மருத்துவம் | மருந்து கண்டுபிடிப்பு, நோயறிதல் மற்றும் தனிப்பட்ட சிகிச்சையை வேகப்படுத்துதல் | உயிரியல் தகவல்களைத் தவறான நோக்கத்திற்குப் பயன்படுத்துதல் |
| அறிவியல் | அறிவியல் புதிய பொருட்கள், ஆற்றல் தொழில்நுட்பம் மற்றும் காலநிலைத் தீர்வுகள் | சோதிக்கப்படாத கண்டுபிடிப்புகள் பெரிய அளவில் பயன்படுத்தப்படுதல் |
| பொருளாதாரம் | உற்பத்தித்திறன் உயர்வு மற்றும் புதிய தொழில்கள் | வேலைவாய்ப்பு இழப்பு மற்றும் வருமானச் சமமின்மை |
| சைபர் பாதுகாப்பு | தாக்குதல்களை முன்கூட்டியே கண்டறிந்து தடுப்பது | தானியங்கி மற்றும் பெரிய அளவிலான சைபர் தாக்குதல்கள் |
| நிர்வாகம் | தரவு அடிப்படையிலான வேகமான முடிவுகள் | சில நிறுவனங்கள் அல்லது அரசுகளிடம் அதிக அதிகாரம் குவிதல் |
| சமூக நலம் | கல்வி, சுகாதாரம் மற்றும் பொது சேவைகளுக்கான அணுகலை விரிவுபடுத்துதல் | தவறான தகவல், கண்காணிப்பு மற்றும் மனித சுயாதீனம் பாதிக்கப்படுதல் |
OpenAI மற்றும் Hugging Face சம்பவம் என்ன?
2026 ஜூலையில் OpenAI நிறுவனத்தின் உள் சைபர் பாதுகாப்புச் சோதனையின்போது, குறைக்கப்பட்ட பாதுகாப்புக் கட்டுப்பாடுகளுடன் இயக்கப்பட்ட சில AI மாடல்கள் அவற்றுக்காக அமைக்கப்பட்ட தனிமைப்படுத்தப்பட்ட “Sandbox” சூழலின் கட்டுப்பாடுகளை மீறின. அவை மென்பொருள் அமைப்பிலிருந்த பாதுகாப்பு குறைபாடுகளைப் பயன்படுத்தி இணைய அணுகலைப் பெற்று, OpenAI-யின் உள் ஆராய்ச்சி அமைப்புகள் மற்றும் Hugging Face தளத்தின் சில பகுதிகளை அனுமதியின்றி அணுகின.
இந்த முகவர்கள் மனிதரால் Hugging Face தளத்தைத் தாக்குமாறு நேரடியாக அறிவுறுத்தப்படவில்லை. அவை தங்களுக்கு வழங்கப்பட்ட சைபர் சோதனையில் வெற்றி பெறுவதற்கான பதில்களைத் தேடும்போது, இலக்கின் வரம்பைத் தாங்களே விரிவுபடுத்தியதாக OpenAI விளக்கியது. பல அமைப்புகளின் பாதுகாப்புப் பலவீனங்களைப் பயன்படுத்துதல், அனுமதிக்கப்படாத தகவல் தொடர்பு வழிகளை அமைத்தல் மற்றும் வெளிப்புற அமைப்புகளை அணுகுதல் போன்ற செயல்கள் பதிவாகின. இது மிகவும் திறமையான AI முகவர்களுக்கு இலக்கை மட்டும் வழங்கிவிட்டு, அந்த இலக்கை அடையும் வழிகளைத் தாங்களே தேர்ந்தெடுக்க அனுமதிப்பதில் உள்ள அபாயத்தை வெளிப்படுத்தியது.
இந்தச் சம்பவத்தை “எச்சரிக்கை மணி” என OpenAI குறிப்பிட்டது. மேலும் தனிமைப்படுத்தப்பட்ட Sandbox அமைப்புகள், இணைய அணுகலுக்கான கடுமையான கட்டுப்பாடுகள், Model Weights பாதுகாப்பு மற்றும் தவறான AI செயல்பாடுகளை வேகமாகக் கண்டறியும் கண்காணிப்பு முறைகள் உள்ளிட்ட பாதுகாப்பு நடவடிக்கைகளை மேம்படுத்துவதாக அந்நிறுவனம் தெரிவித்தது.
‘Pace the Frontier’ திட்டத்தின் முக்கிய அம்சம்
Dario Amodei முன்வைத்த திட்டத்தின் மையக் கருத்து, முன்னணி AI நிறுவனங்களுக்குள் நிரந்தரமாகச் செயல்படக்கூடிய சுயாதீன பாதுகாப்பு மதிப்பீட்டாளர்களை அனுமதிப்பதாகும். இவர்களுக்கு சாதாரணமாக வெளியிடப்பட்ட இறுதி மாடல்களைச் சோதிக்கும் அனுமதி மட்டும் இல்லாமல், பயிற்சி நடைமுறை, பாதுகாப்பு விதிகள், Alignment ஆய்வு மற்றும் சாத்தியமான சம்பவங்களைத் தொடர்ந்து மதிப்பிடக்கூடிய “Employee-like access” வழங்கப்பட வேண்டும் என அவர் பரிந்துரைத்துள்ளார். Anthropic தனது அமைப்புகளில் இந்த அணுகலை வழங்க ஒருதலைப்பட்சமாக முன்வந்துள்ளது.
இதன் பெரிய மாற்றம் வெளிப்படைத்தன்மையில் இருக்கிறது. நிறுவனங்கள் தங்களது மாடல்கள் பாதுகாப்பானவை என்று தாங்களே கூறுவதற்குப் பதிலாக, வெளிப்புற நிபுணர்கள் அவற்றைத் தொடர்ந்து ஆய்வு செய்து கண்டறியும் குறைபாடுகளைச் சுதந்திரமாகப் பதிவு செய்ய முடியும். இருப்பினும், மதிப்பீட்டாளர்களின் பரிந்துரைகளை நிறுவனங்கள் கட்டாயமாக ஏற்க வேண்டுமா, அவர்களுக்கு சட்டப்பூர்வ அதிகாரம் இருக்குமா என்பதற்கான தெளிவான உலகளாவிய விதிகள் இன்னும் உருவாகவில்லை.
Sam Altman மற்றும் Elon Musk ஆதரவு
கடுமையான வணிகப் போட்டியாளர்களாக இருந்தாலும் OpenAI தலைமைச் செயல் அதிகாரி Sam Altman மற்றும் xAI நிறுவனரான Elon Musk ஆகியோர் Amodei முன்வைத்த கருத்துக்கு ஆதரவு தெரிவித்தனர். OpenAI நிறுவனத்திலும் சுயாதீன மதிப்பீட்டாளர்களுக்கு ஊழியர்களுக்கு இணையான அணுகலை வழங்கும் யோசனையைப் பின்பற்ற உள்ளதாக Altman கூறினார். Musk, “Dario is right” எனச் சுருக்கமாகப் பதிவிட்டார்.
இந்த ஆதரவு AI வளர்ச்சியை முழுமையாக நிறுத்துவதற்கான ஒப்புதல் அல்ல. மாறாக, மாடல்களின் புதிய திறன்களுக்கும் பாதுகாப்பு ஏற்பாடுகளுக்கும் இடையிலான இடைவெளியைச் சுருக்க வேண்டும் என்ற பொதுவான நிலைப்பாடு. Altman தனது விளக்கத்தில் “Pacing” என்பது “Stopping” அல்ல என்றும், வணிகப் போட்டியின் அழுத்தம் பொறுப்பற்ற வளர்ச்சியை நியாயப்படுத்தக் கூடாது என்றும் தெளிவுபடுத்தியுள்ளார்.
அமெரிக்கா மற்றும் சீனாவின் மாறுபட்ட நிலைப்பாடு
அமெரிக்க அதிபர் Donald Trump, AI வளர்ச்சியின் வேகத்தைக் குறைப்பது சீனாவுக்கு போட்டி முன்னிலை வழங்கக்கூடும் எனக் கூறி இந்தக் கோரிக்கைகளை நிராகரித்தார். AI போட்டியில் வெற்றி பெறும் நாடே எதிர்கால அதிகாரச் சமநிலையை நிர்ணயிக்கும் என்ற நிலைப்பாட்டை அவர் முன்வைத்துள்ளார். இதனால் AI பாதுகாப்பு விவாதம் தொழில்நுட்பப் பிரச்சினையாக மட்டும் இல்லாமல், தேசிய பாதுகாப்பு மற்றும் சர்வதேசப் போட்டியின் ஒரு பகுதியாக மாறியுள்ளது.
AI போட்டியில் வெற்றி பெறும் நாடே எதிர்கால அதிகாரச் சமநிலையை நிர்ணயிக்கும்
சீன வெளியுறவு அமைச்சக செய்தித் தொடர்பாளர் Guo Jiakun, அச்சத்தைத் தூண்டுதல், மோதல் மனப்பான்மை மற்றும் கடுமையான போட்டி ஆகியவை உலகளாவிய AI நிர்வாகத்தைப் பாதிக்கும் எனத் தெரிவித்தார். AI அனைவரின் நலனுக்கும் திறந்த மற்றும் உள்ளடக்கிய முறையில் வளர்க்கப்பட வேண்டும் என்பது சீனாவின் அதிகாரப்பூர்வ நிலைப்பாடு. அதே நேரத்தில் சில சீன ஊடகங்கள் அமெரிக்க நிறுவனங்கள் முன்வைக்கும் கட்டுப்பாடுகள் சீனாவின் வளர்ச்சியைத் தடுக்க முயலும் தொழில்நுட்பப் போட்டித் திட்டமாக இருக்கலாம் என விமர்சித்துள்ளன.
AI அனைவரின் நலனுக்கும் திறந்த மற்றும் உள்ளடக்கிய முறையில் வளர்க்கப்பட வேண்டும்
சூப்பர் இன்டெலிஜென்ஸ் விவாதத்தின் நோக்கம் என்ன?
AI வளர்ச்சியை நிறுத்துவதா அல்லது தொடர்வதா என்பது மட்டும் கேள்வியல்ல. ஒவ்வொரு புதிய திறனுக்கும் முன்பாக நம்பகமான பாதுகாப்புச் சோதனை, மனிதக் கட்டுப்பாடு, சுயாதீன தணிக்கை, சம்பவ வெளிப்படுத்தல் மற்றும் சர்வதேச ஒத்துழைப்பு இருப்பதை எப்படி உறுதி செய்வது என்பதே உண்மையான சவால்.
வளர்ச்சியையும் பாதுகாப்பையும் இணைக்க முடியுமா?
சூப்பர் இன்டெலிஜென்ஸ் உருவாகும் காலம் குறித்து இதுவரை அறிவியல் ஒற்றுமை இல்லை. அது விரைவில் உருவாகலாம் என்று சிலர் நம்புகின்றனர். இன்னும் பல தசாப்தங்கள் ஆகலாம் அல்லது தற்போதைய தொழில்நுட்பப் பாதையில் அது எட்டப்படாமலும் போகலாம் என்று மற்றவர்கள் கருதுகின்றனர். எனவே உறுதிப்படுத்தப்படாத காலக்கெடுக்களை அடிப்படையாகக் கொண்டு அச்சத்தை ஏற்படுத்துவதற்குப் பதிலாக, ஏற்கனவே காணப்படும் தன்னாட்சி, சைபர் பாதுகாப்பு மற்றும் கண்காணிப்புக் குறைபாடுகளைச் சரிசெய்வது அவசியம்.
AI மூலம் நோய்களுக்கு மருந்து கண்டுபிடிக்கவும், காலநிலை மாற்றத்திற்கான தீர்வுகளை உருவாக்கவும், கல்வி மற்றும் அறிவியல் ஆராய்ச்சியை மேம்படுத்தவும் முடியும். அதே திறன்கள் பாதுகாப்பின்றி பயன்படுத்தப்பட்டால் பெரிய அளவிலான பாதிப்புகளையும் உருவாக்கலாம். அதனால் பாதுகாப்பு என்பது வளர்ச்சிக்கு எதிரான தடையாக இல்லாமல், நம்பகமான AI வளர்ச்சிக்கான அடிப்படை கட்டமைப்பாகவே பார்க்கப்பட வேண்டும்.
மனிதனை மிஞ்சும் சூப்பர் இன்டெலிஜென்ஸ் இன்னும் ஒரு கற்பனையான எதிர்காலத் தொழில்நுட்பமாக இருக்கலாம். ஆனால் தன்னாட்சி AI முகவர்கள் கட்டுப்பாட்டை மீறிச் செயல்பட்ட சமீபத்திய சம்பவங்கள், பாதுகாப்பு குறித்த விவாதத்தை எதிர்காலத்திற்குத் தள்ளிவைக்க முடியாது என்பதை உணர்த்துகின்றன.
AI வளர்ச்சியின் வேகத்தைக் குறைப்பது மட்டுமே முழுமையான தீர்வாக இருக்காது. அதேபோல் கட்டுப்பாடற்ற போட்டியும் பாதுகாப்பான வழி அல்ல. நிறுவனங்களின் வெளிப்படைத்தன்மை, சுயாதீனப் பாதுகாப்பு மதிப்பீடு, அரசுகளின் பொறுப்பான சட்டங்கள் மற்றும் சர்வதேச அளவிலான சரிபார்க்கக்கூடிய ஒப்பந்தங்கள் ஒன்றிணைந்தால்தான் AI வழங்கும் நன்மைகளைப் பாதுகாப்பாகப் பயன்படுத்த முடியும். இப்போது உலகம் எடுக்கும் முடிவுகள் ஒரு புதிய தொழில்நுட்பத்தின் எதிர்காலத்தை மட்டும் அல்ல, அந்தத் தொழில்நுட்பத்தின் மீது மனிதர்களுக்கு இருக்கும் கட்டுப்பாட்டையும் தீர்மானிக்கக்கூடும்.